10X
更快的推理啟動時間
更快推向市場
- 透過全棧 AI 原生雲平臺,以行業領先的速度和規模獲得 NVIDIA 顯示卡資源,加快 AI 開發週期,更快將解決方案推向市場。
- 我們的 Kubernetes 原生開發體驗擁有前沿裸機基礎設施、自動化配置,以及對主流工作負載編排框架的支援。
毫秒級喚醒全棧雲原生算力矩陣。智慧匹配異構的 GPU 例項,全速驅動 AI 大模型與推理引擎。
超過一萬家公司,從初創企業到財富 500 強,都在我們的平臺上運營業務。
覆蓋 20,000+ GPU 的透明算力供給,按需租用、實時查詢、快速交付。
FP32 51.2 TFLOPS / Tensor 756.0 TFLOPS
FP32 N/A / Tensor N/A
FP32 126.0 TFLOPS / Tensor 503.8 TFLOPS
FP32 19.5 TFLOPS / Tensor 312 TFLOPS
FP32 104.8 TFLOPS / Tensor 210 TFLOPS
FP32 15.7 TFLOPS / Tensor 125 TFLOPS
FP32 82.58 TFLOPS / Tensor 165.2 TFLOPS
FP32 35.58 TFLOPS / Tensor 71 TFLOPS
FP32 34.10 TFLOPS / Tensor 70 TFLOPS
FP32 19.17 TFLOPS / Tensor 76.7 TFLOPS
FP32 13.45 TFLOPS / Tensor 53.8 TFLOPS
INT8 N/A / INT16 N/A
根據機器在真實 AI 場景下的表現,幫助你判斷租哪臺更合適。
面向文字、影象、影片、語音等熱門需求分配伺服器資源。
實時檢視機器的 Token 處理能力與任務表現,選擇更有依據。
從租賃費用到執行產出,關鍵資料持續可見。
減少機器空閒與切換損耗,讓伺服器更專注於實際任務。
你關注機型和收益,平臺處理接入與執行流程。
體驗新一代 AI 基礎設施。高效能 GPU 叢集專為高要求工作負載而設計。
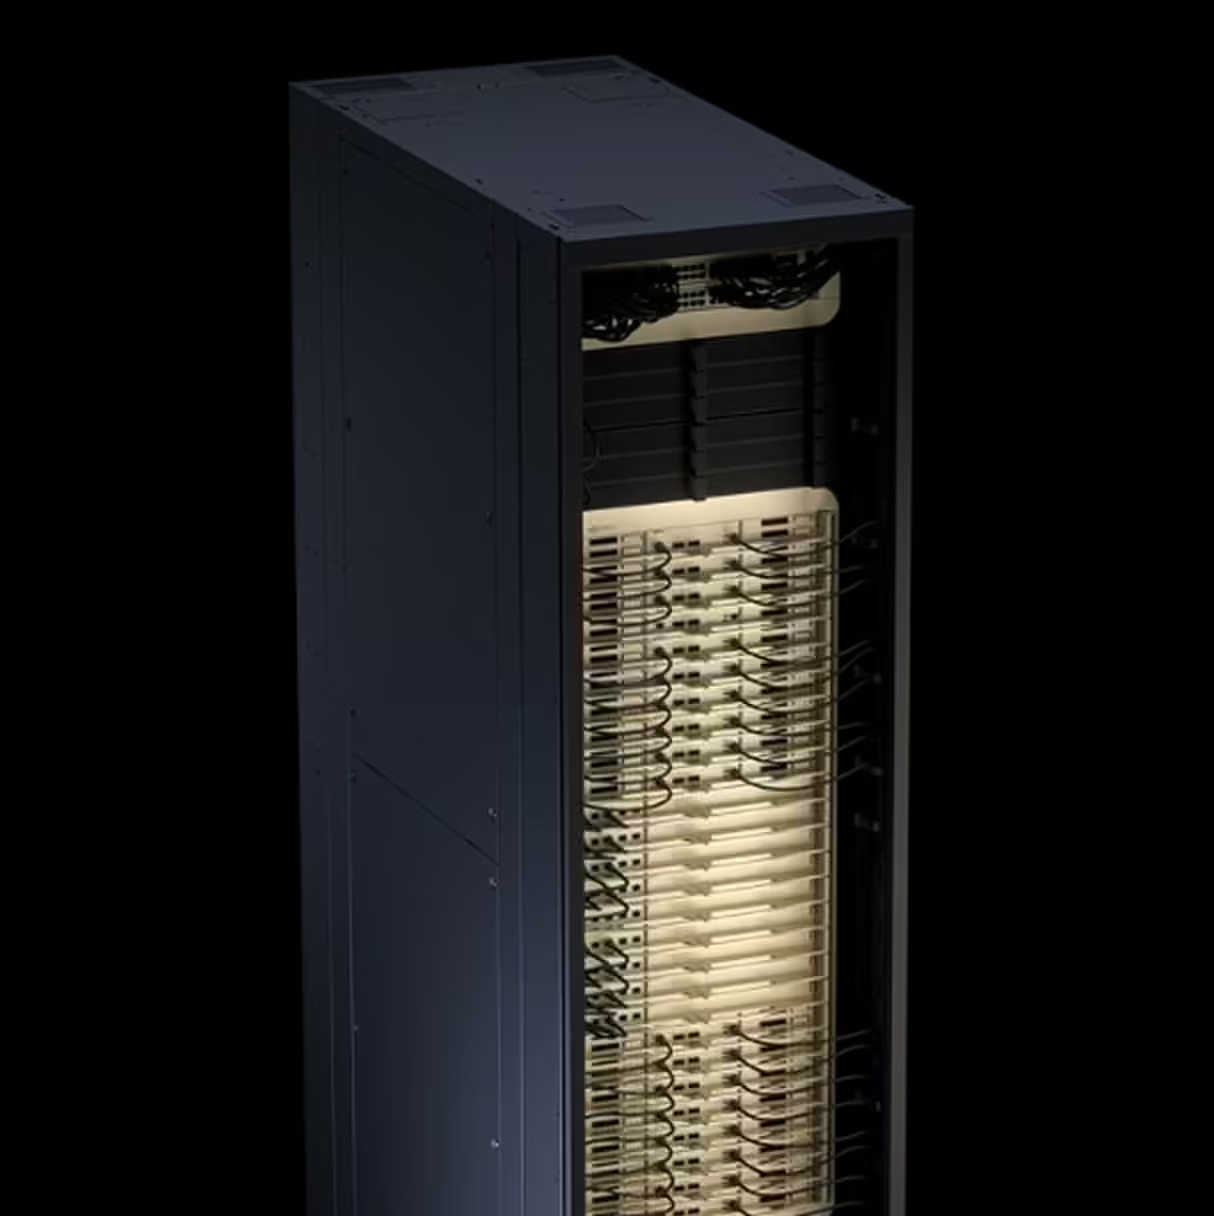
面向智慧體 AI 最佳化的機架級系統。
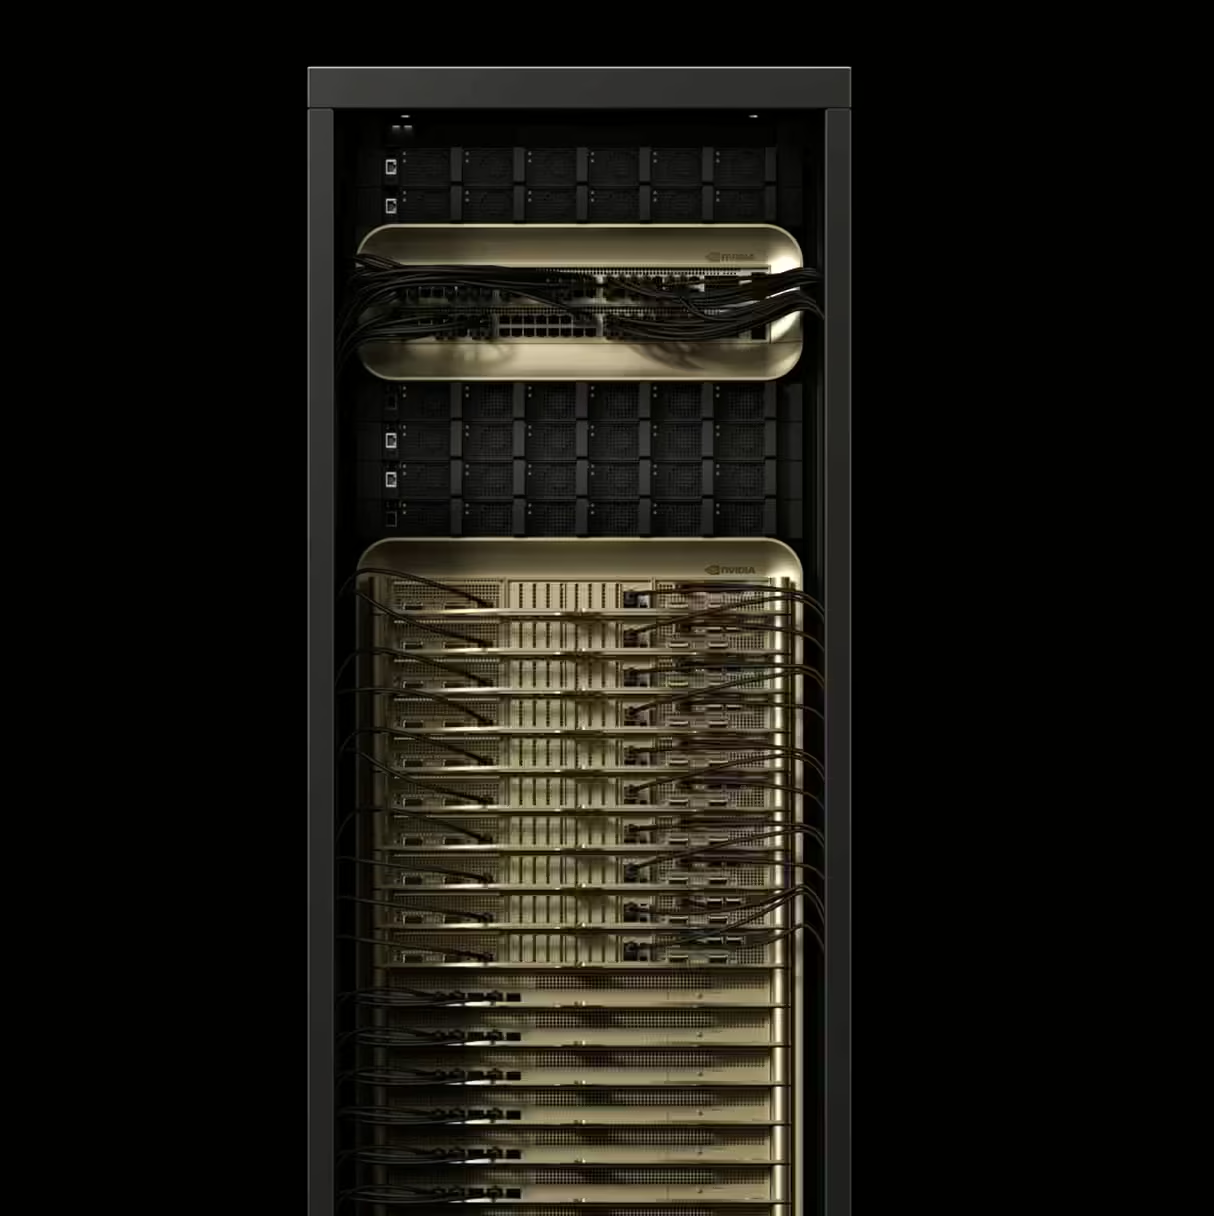
面向 AI 推理最佳化的機架級系統。
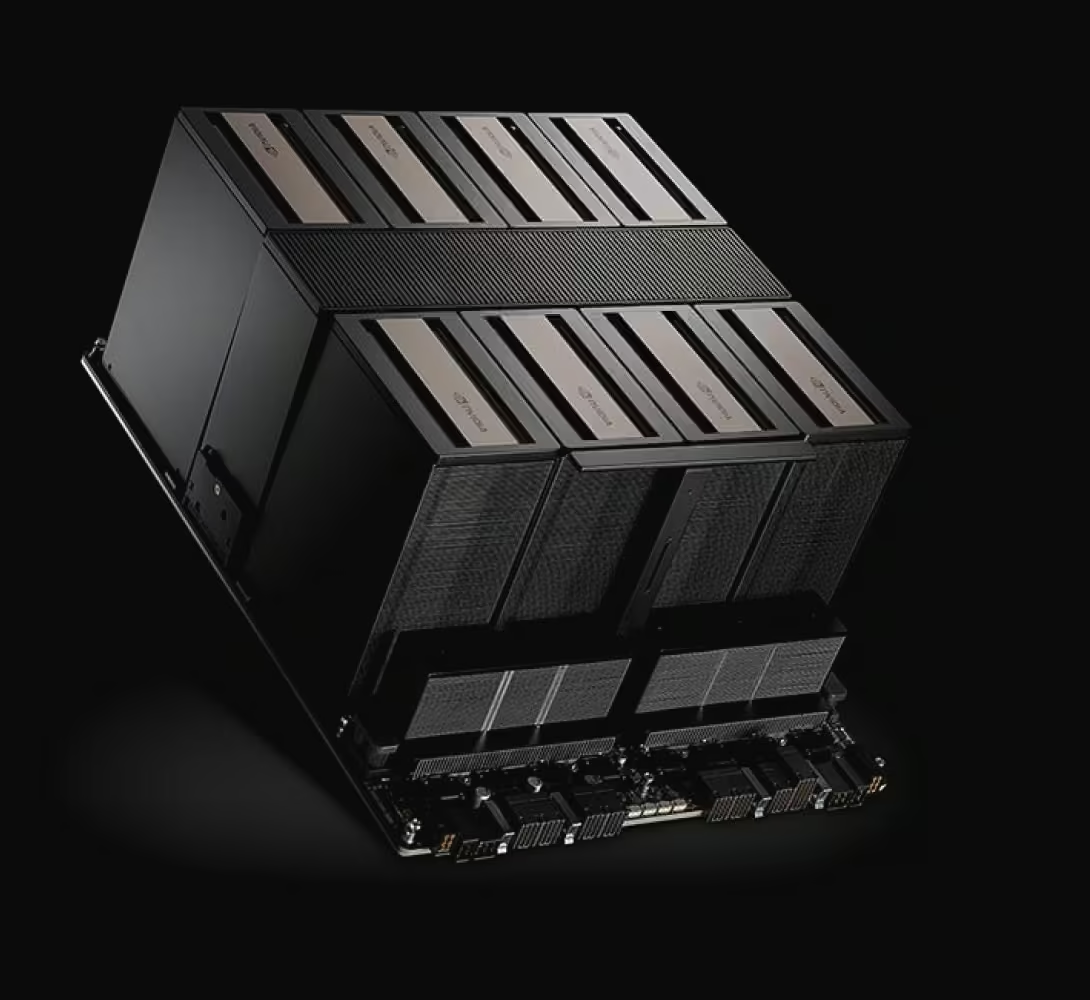
以峰值能效支援更長訓練執行時間。
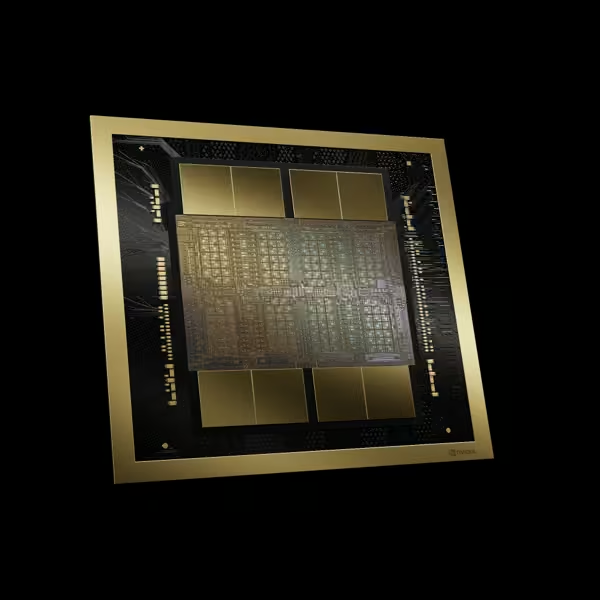
適合微調和推理的通用 GPU 基礎設施。
我們透過提供高價值的效能、規模和專業知識,彌合人工智慧雄心與執行之間的鴻溝。
10X
更快的推理啟動時間
96%
叢集吞吐量
50%
每天的中斷減少
專為規模化而打造,安全可靠,旨在滿足您最苛刻的需求。
憑藉業界領先的可靠性,您可以自信地執行關鍵工作負載。
經獨立審計的控制措施與端到端資料保護,支援企業安全要求。
利用可隨您發展而擴充套件的基礎設施,即時適應需求。
面向機器學習團隊的探索、實驗、協作和構建中心,把模型評估、資料集檢視和專案展示放在同一個工作流裡。
內建模型評估、資料集檢視等機器學習工作流能力。

基於 Git,並以共享開發和評審為核心設計。
透過動手實驗和優秀社群案例持續學習。
與世界分享你的作品,打造可展示的機器學習檔案。
獲取WebCal、GPU 叢集和 AI 基礎設施的最新實踐與產品洞察。
前 OpenAI 研究員 Diogo Almeida 創辦 TypeSafe AI,推出不生成句子的決策模型 Jev。它透過強型別選擇、評分與機率輸出,瞄準低延遲自動化、瀏覽器代理、上下文壓縮和模型路由。
繼續閱讀Stripe被曝正以接近100億美元估值洽談收購OpenRouter。本文梳理OpenRouter的AI模型路由模式、增長與融資,以及Stripe從支付基礎設施延伸至AI基礎設施的戰略邏輯,並比較海內外AI閘道生態。
繼續閱讀從資訊品質、上下文管理、提示詞結構與模型選擇出發,說明為什麼 Token 越多不等於效果越好,並總結一般使用者高效運用 AI 的五項原則。
繼續閱讀從輸入和輸出 Token、計費公式、長對話和文件成本講起,解釋模型價差、官方價格查詢方式,以及普通使用者如何減少無效 Token 消耗。
繼續閱讀