Jev, la nueva estrella mundial de la IA, no dice una palabra: ¿cómo funciona?
Resumen
El exinvestigador de OpenAI Diogo Almeida fundó TypeSafe AI y lanzó Jev, un modelo de decisión que no genera frases. Sus opciones, puntuaciones y probabilidades tipadas se orientan a la automatización de baja latencia, agentes de navegador, compresión de contexto y enrutamiento de modelos.
No dejan de aparecer nuevos modelos, todos deseosos de demostrar que pueden escribir y conversar. Sin embargo, el modelo que ahora acapara la atención mundial es Jev.
Jev no habla.
Diogo Almeida fue investigador de OpenAI, participó en el desarrollo de ChatGPT y posteriormente propuso el aprendizaje por refuerzo con retroalimentación humana, o RLHF.
Ese enfoque definió en buena medida la evolución de los grandes modelos de lenguaje durante los últimos años. Pero, mientras impulsaba el auge del sector, Almeida empezó a cuestionarlo cada vez más.
«Tuvimos una innovación puntual que funcionó, pero no la convertimos en algo realmente útil».
Tardó mucho en identificar el problema: la industria llevaba años optimizando el procesamiento del lenguaje humano. Los modelos llegaron a hacerlo muy bien, pero aquello servía poco para automatizar, porque los ordenadores emplean un «lenguaje» diferente.
Hace dos años, Almeida dejó OpenAI y fundó TypeSafe AI con Erik Gafni y Sasha Sheng. La empresa permaneció en secreto hasta el 15 de septiembre, cuando anunció una ronda semilla de 40 millones de dólares liderada por DCVC y su primer modelo, Jev.
Jev sigue basado en Transformer, pero deliberadamente no es un gran modelo de lenguaje y no genera frases completas.
Al recibir el estado de un programa y una pregunta predefinida, devuelve una respuesta tipada: una opción, una puntuación o una probabilidad entre 0 y 1, acompañada de un nivel de confianza.
TypeSafe denomina a estas salidas «decisiones calibradas». De ahí la confusión que produjo Jev cuando apareció por primera vez ante el público.
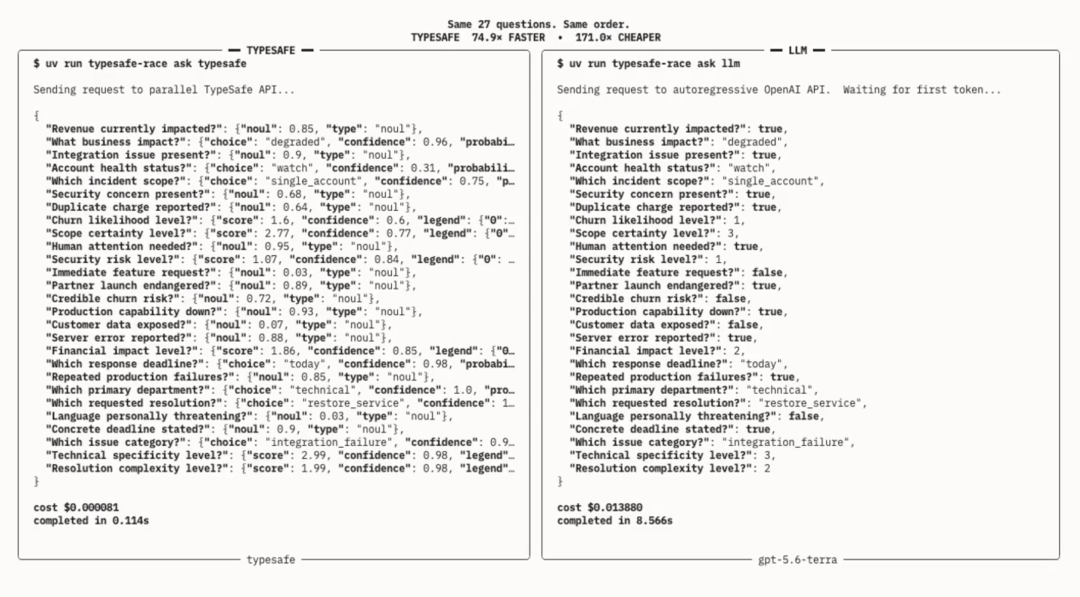
La imagen compara la respuesta de Jev y la de un gran modelo de lenguaje ante la misma solicitud.
El modelo más popular de la IA sigue un camino distinto al de ChatGPT
Para entender qué hace Jev, conviene dejar de lado la forma habitual de pensar en los grandes modelos de lenguaje.
Pensemos en atención al cliente. Un usuario avisa de que el servicio de pagos lleva días sin funcionar y perjudica su negocio. Hay que decidir si corresponde al equipo técnico o al de facturación, cuánto descontento existe y si el caso es urgente.
En la interfaz de TypeSafe, las preguntas de una misma solicitud comparten una entrada, pero se evalúan de forma independiente y en paralelo. La clasificación y la urgencia pueden resolverse a la vez.
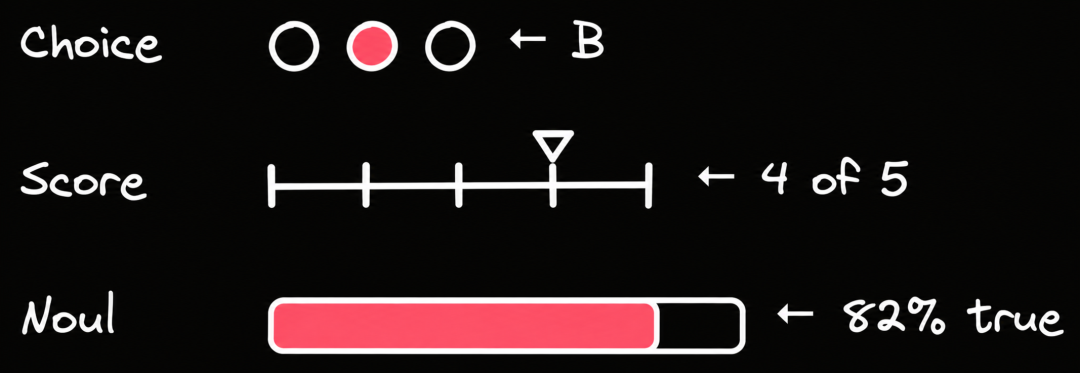
Hay tres formas básicas de salida. Choice selecciona un elemento de una lista definida por el usuario, con hasta 255 opciones, y sirve para clasificación y enrutamiento. Score sitúa la entrada en una escala definida para medir urgencia, calidad o riesgo. Noul es una decisión de sí o no cuyo valor numérico representa la probabilidad de que una afirmación sea cierta.
Cada respuesta incluye la distribución completa de probabilidades y una puntuación de confianza. El resultado está fuertemente tipado: no hacen falta indicaciones JSON, analizadores adicionales ni medidas contra una respuesta envuelta de improviso en un bloque de código Markdown.
Las ventajas inmediatas son menos tiempo, menor coste y menos errores de formato derivados de la generación libre.
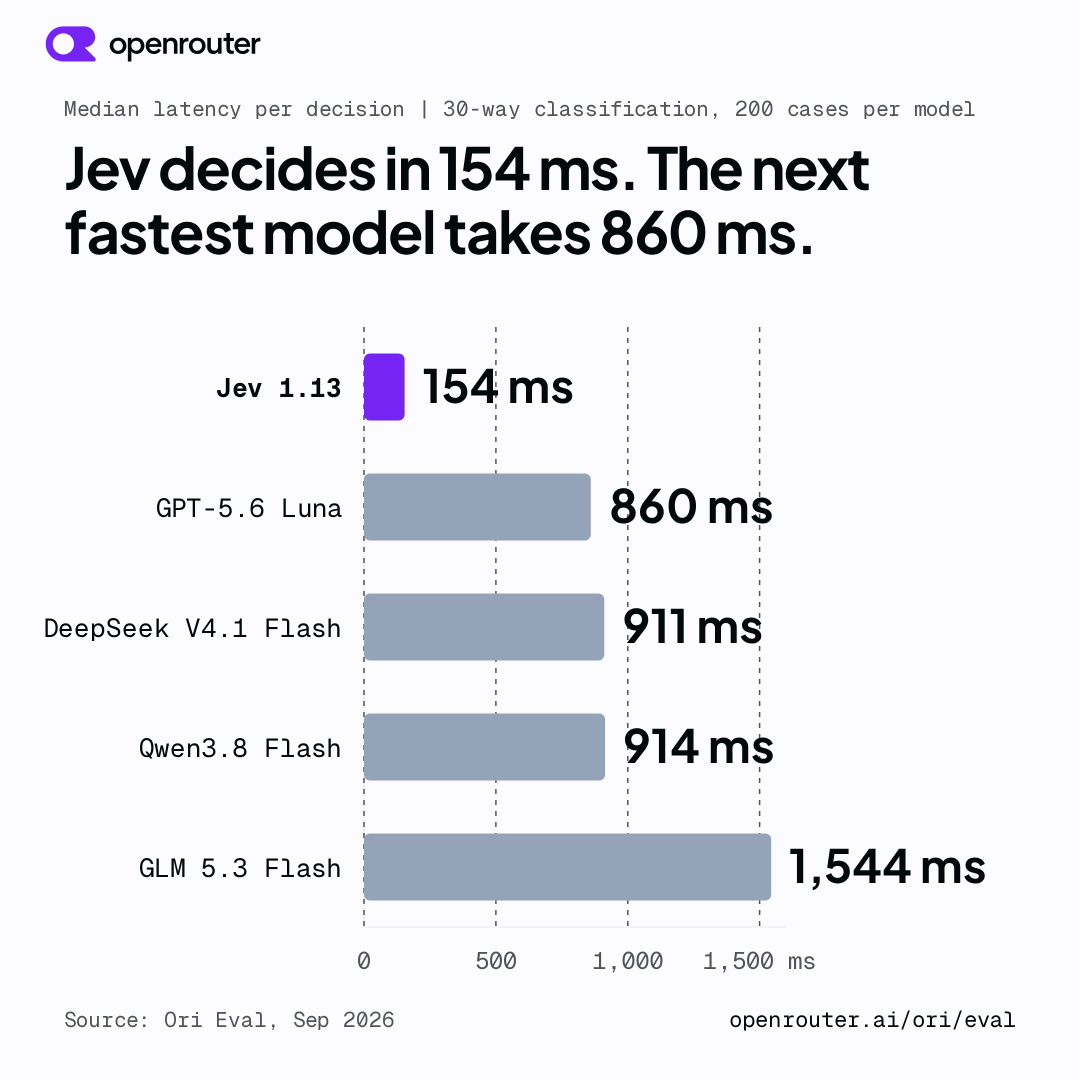
Según TypeSafe, la latencia de extremo a extremo de Jev se sitúa entre 70 y 500 milisegundos, de 20 a 200 veces menos que la de modelos comparables.
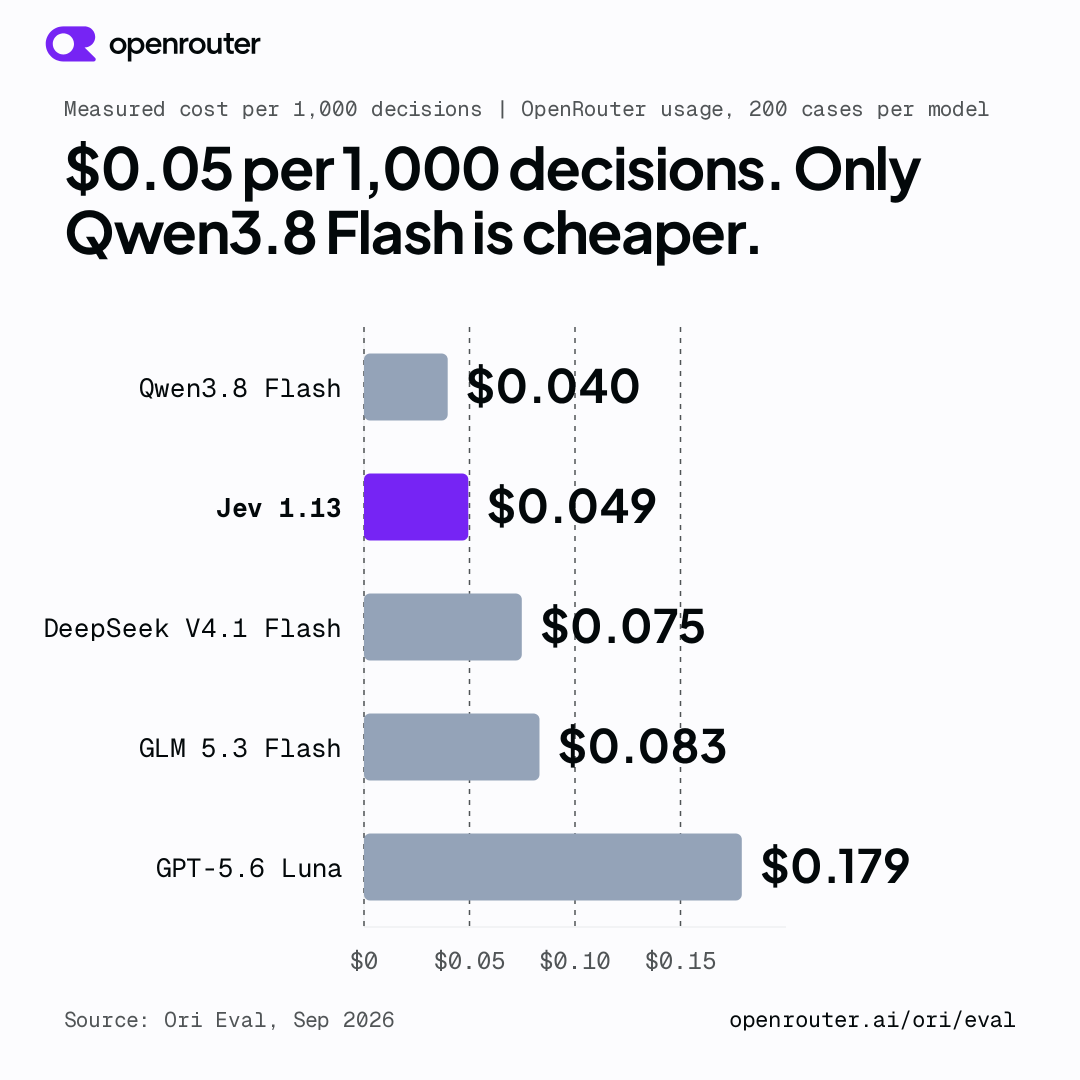
Con el precio público actual, la entrada cuesta 42 dólares por mil millones de token, o 0,042 dólares por millón; la salida es gratuita. Las preguntas adicionales y las descripciones de opciones consumen token de entrada, pero no se cobra aparte por la longitud de una respuesta generada.
Como el usuario define de antemano los resultados posibles, el modelo no alucina fuera de esas opciones. Esto no significa que siempre acierte: todavía puede escoger una opción equivocada dentro del conjunto permitido.
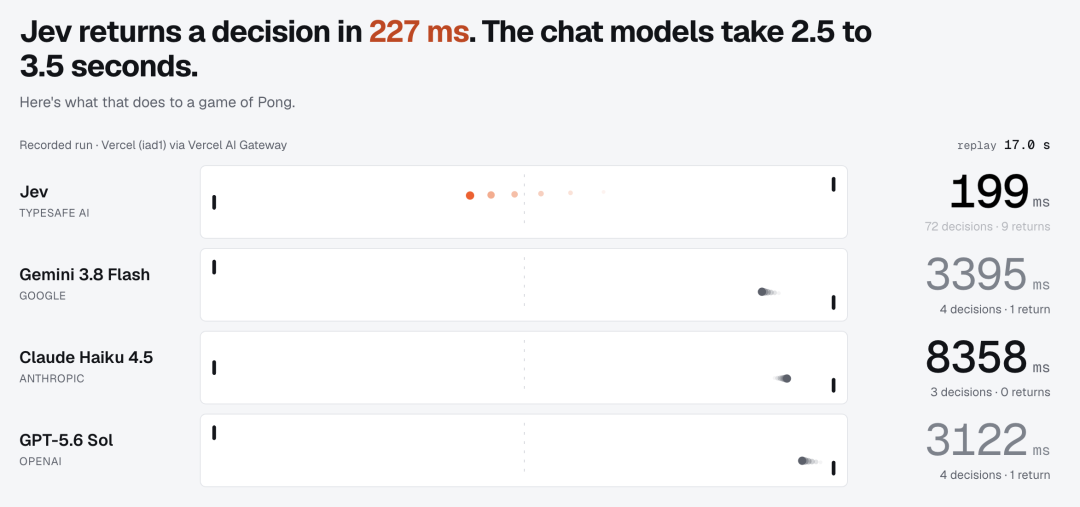
En una demostración pública de Ably Pong, Jev tomó 47 decisiones de control en 12 segundos. Gemini, Claude y GPT solo tomaron dos o tres durante el mismo periodo, aunque generalmente acertaron.
El programa entregaba directamente a Jev los datos numéricos del juego: posición y dirección de la pelota, posición de la pala y coordenada vertical prevista al llegar. Jev elegía entre subir, bajar o quedarse quieto.
Formas de utilizar Jev
Crear un producto jugable con Jev sigue exigiendo lógica de juego y comunicación en tiempo real. En el proyecto anterior, el servidor hace avanzar la partida y llama al modelo, mientras Ably envía el nuevo estado al navegador. Jev no genera las reglas, los gráficos ni la conexión: solo interviene en la decisión de tres opciones que se ejecuta repetidamente.
La velocidad amplía los usos posibles. Jev puede actuar como capa de decisión para controlar un ordenador y ayudar a los agentes a ejecutar instrucciones con rapidez. También puede comprimir contexto al identificar la información importante y reducir rápidamente millones de token.
El proyecto público jev-ultrafast de Browser Use implementa un agente de navegador. En cada página lee los elementos interactivos y crea una lista numerada: botones, campos de entrada, nombres y valores actuales.
Jev recibe ese estado estructurado, el objetivo del usuario y el historial de acciones. El programa genera dinámicamente las opciones disponibles a partir de los elementos que existen en la página.
Usar Jev como capa de decisión para manejar un ordenador rápidamente
Para buscar un vuelo, el objetivo podría ser: «Busca un vuelo de ida de Zúrich a Londres, configura la fecha, el número de pasajeros y la clase indicados, y detente cuando aparezcan resultados válidos».
En cada ronda se preguntan varias cosas a la vez: ¿hacer clic, escribir, seleccionar una opción o esperar? Si hay que hacer clic, ¿en qué número? Si hay que escribir, ¿en qué campo? Todas las preguntas comparten el estado de la página, pero se responden por separado.
El programa solo utiliza el objetivo que corresponde a la acción elegida. Si la acción es hacer clic, usa el destino del clic e ignora temporalmente las demás respuestas.
Cuando debe introducirse el nombre de una ciudad, el programa llama por separado a un pequeño modelo generativo para producir el texto según el objetivo y el campo actual. Después de ejecutar la acción, vuelve a leer el estado de la página.
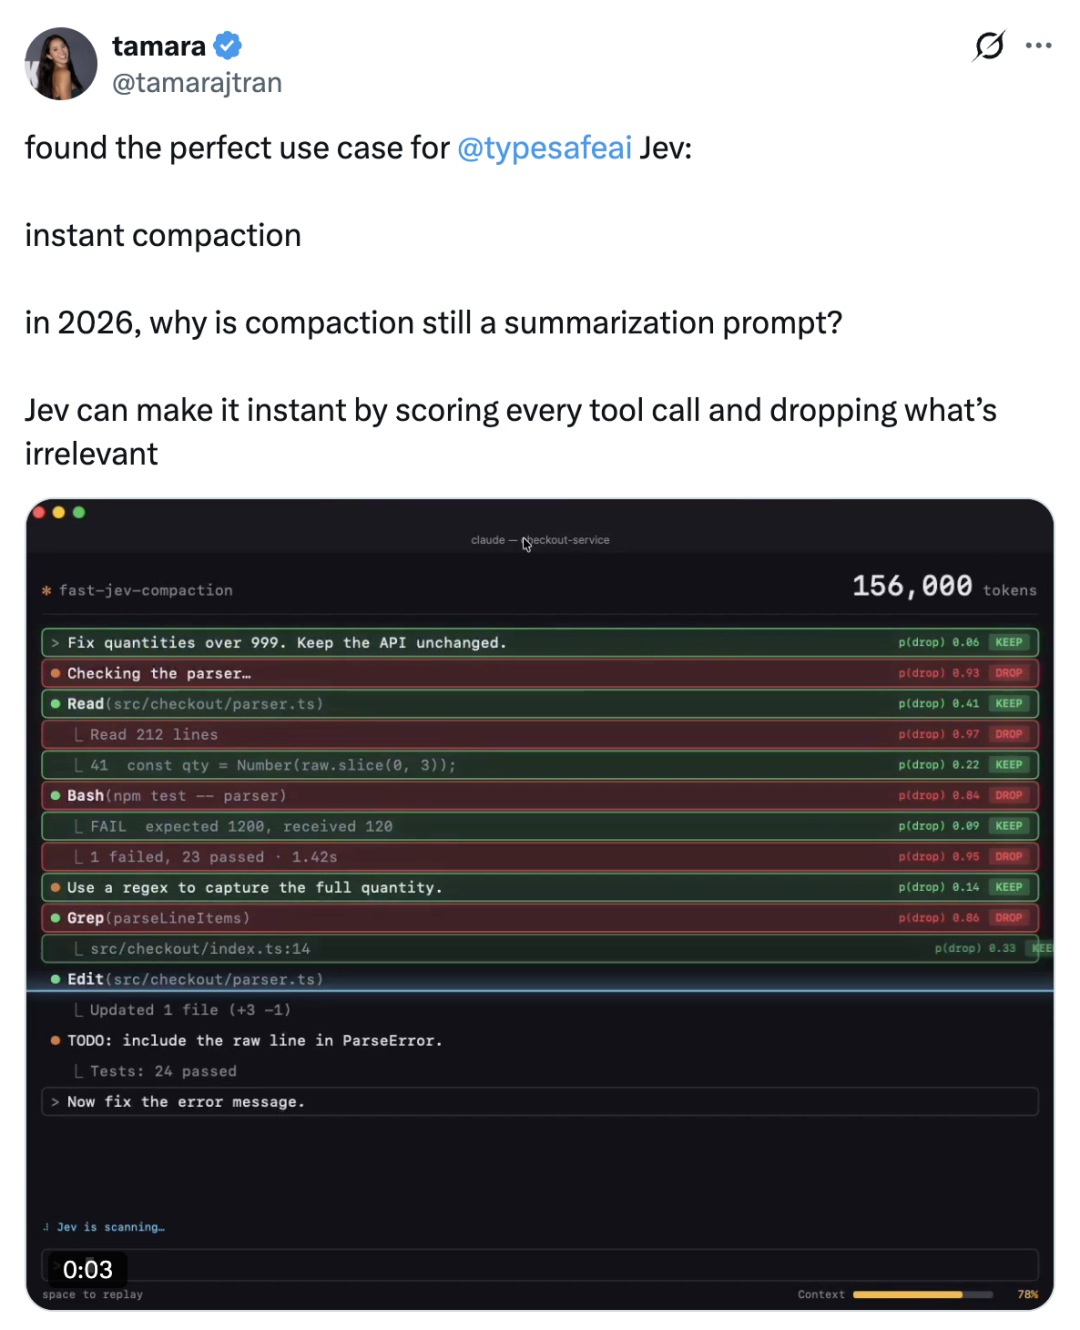
Usar Jev para valorar la importancia de la información y comprimir el contexto casi al instante
Pranit Sharma, ingeniero de software de Vercel, explicó que su empresa usaba ChatGPT Luna 5.6 de OpenAI para ejecutar un clasificador de seguridad de comandos. Al sustituir Luna por Jev, el proceso se aceleró entre 5 y 18 veces y la precisión mejoró notablemente.
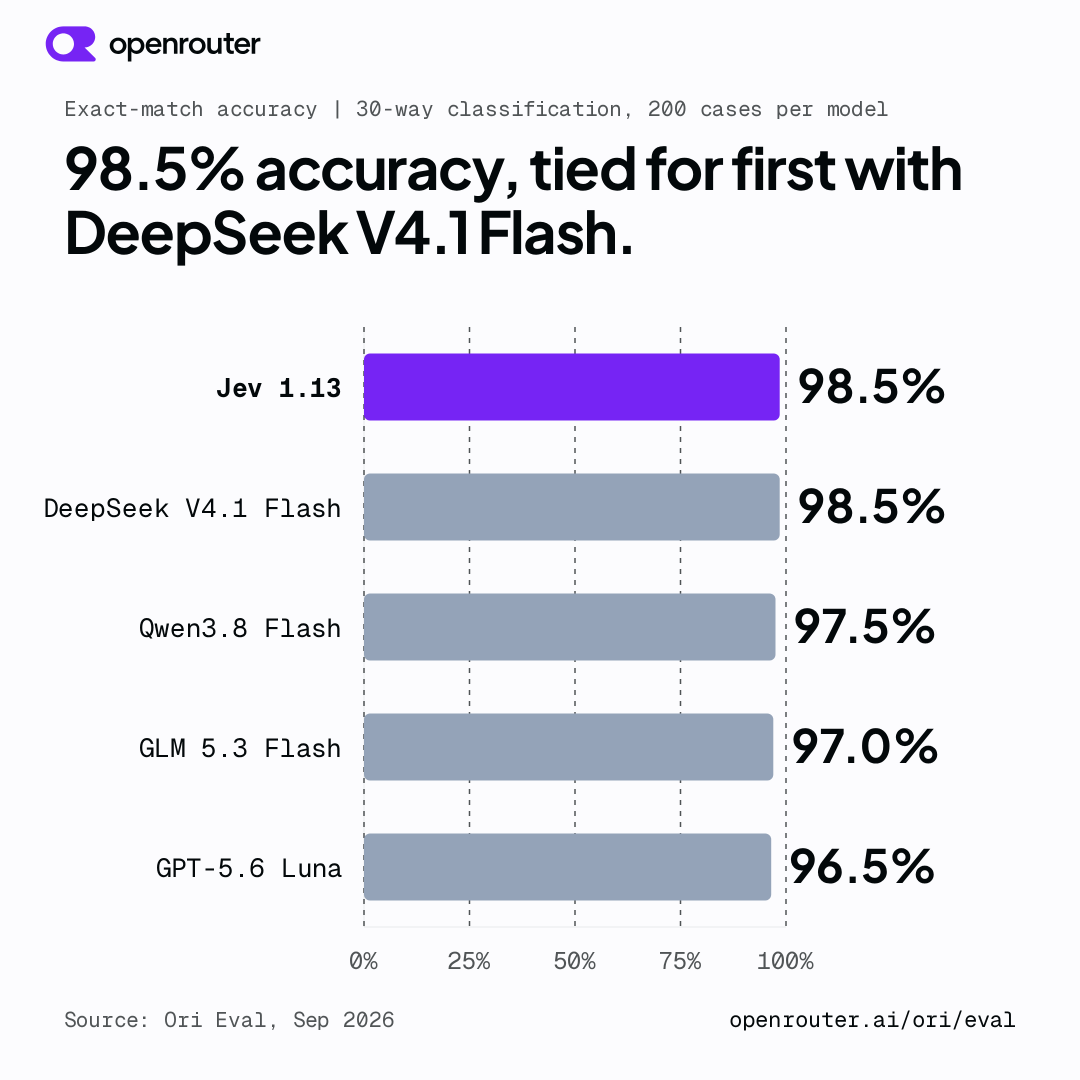
Nikhil Mudholkar, CTO de Bryo AI, comparó Jev y Gemini en la clasificación de correos empresariales. Gemini obtuvo una precisión ligeramente mayor, pero costó entre 10 y 20 veces más.
El mismo esquema puede construirse de forma independiente. Basta con preparar una tabla con asunto, cuerpo, hora de recepción y contexto necesario, y dividir el trabajo en preguntas claras.
Para un correo que dice «Mi pedido se cobró dos veces y necesito resolverlo hoy», Choice decide si va a soporte, ventas, alianzas u otra cola; Noul determina si el remitente solicita una acción explícita; y Score establece la prioridad.
«En último término, este enfoque traslada al usuario parte de la responsabilidad de gestionar las alucinaciones», explicó Armin Ronacher, CTO de Earendil. «Si la probabilidad es solo del 50 %, quizá pueda ignorarla; si alcanza el 95 %, puedo utilizarla».
Ronacher señala otro uso potencial: el enrutamiento de modelos. Predecir si una tarea requiere un modelo concreto es útil, pero hacerlo con un gran modelo de lenguaje resulta caro. Jev es suficientemente barato y rápido para enrutar en tiempo real.
Asignar automáticamente el modelo adecuado según la complejidad de la tarea
La decisión más inteligente
El nombre Jev procede del economista del siglo XIX William Stanley Jevons. La paradoja de Jevons afirma que cuando baja el coste de un bien, su uso aumenta. En este caso, reducir el coste de la inteligencia debería extender su utilización.
Cuando una llamada es más barata, se emplea en lugares donde antes no compensaba. Almeida imagina un futuro no dominado por unas pocas aplicaciones gigantes, sino por innumerables pequeñas decisiones inteligentes distribuidas por todas partes, «más parecido al primer internet que a las grandes aplicaciones actuales».
TypeSafe no ha revelado la arquitectura concreta de Jev. Se especula que fue adaptado a partir de algún gran modelo de lenguaje de código abierto.
La empresa llama a esta categoría System One Models, por el concepto de pensamiento intuitivo de Daniel Kahneman. Destaca el juicio intuitivo frente a las cadenas de razonamiento y la adaptación a tareas específicas.
TypeSafe recomienda dividir una decisión compleja en preguntas explícitas y combinar sus respuestas mediante código, en lugar de encargar todo a un único modelo.
Almeida afirmó que haber previsto pronto que trabajaría con datos sintéticos quizá fue la decisión más inteligente de su vida, más que sacar una empresa a bolsa e incluso más que depender de retroalimentación humana real.
TypeSafe es por ahora la única empresa que sigue esta vía, pero Ronacher espera que aparezcan competidores cuando se demuestre su valor práctico. TypeSafe también planea lanzar versiones para distintos escenarios.
Preguntado por si la empresa es un laboratorio de frontera, Almeida respondió: «El principal producto de esos laboratorios es el miedo o la exageración. Espero que nuestro producto principal sea la inteligencia. No somos un laboratorio obsesionado con crear riqueza ilimitada, relatos religiosos o un dios dentro de un centro de datos».
La demanda superó las previsiones tras el lanzamiento y la API dejó de responder brevemente. Un usuario filtró un flujo de información especializado: leyó publicaciones de tres días, formuló ocho preguntas, tardó unos dos segundos y gastó 0,007 dólares para eliminar contenidos señuelo y publicidad oculta.
Otro equipo integró Jev en todo un proceso de análisis de marketing. Escaneó la biblioteca publicitaria de Meta, comparó la vida útil de distintos formatos y evaluó guiones creativos antes de filmarlos, acelerando 30 veces decisiones antes manuales y reduciendo el coste a menos de 3 dólares.
La IA dijo mucho menos, pero el software hizo mucho más.
Estamos buscando nuevos compañeros
📮 Correo para enviar el currículum hr@webcal.ai
✉️ Asunto del correo «Nombre + Puesto» (Incluye proyectos, portafolio o enlaces relevantes junto con el currículum.)
Equipo editorial
Product Team @ WebCal
El equipo oficial de producto de WebCal. Construimos infraestructura de cómputo de alto rendimiento y soluciones cloud descentralizadas.