10X
更快的推理启动时间
更快推向市场
- 通过全栈 AI 原生云平台,以行业领先的速度和规模获得 NVIDIA 显卡资源,加快 AI 开发周期,更快将解决方案推向市场。
- 我们的 Kubernetes 原生开发体验拥有前沿裸机基础设施、自动化配置,以及对主流工作负载编排框架的支持。
毫秒级唤醒全栈云原生算力矩阵。智能匹配异构的 GPU 实例,全速驱动 AI 大模型与推理引擎。
超过一万家公司,从初创企业到财富 500 强,都在我们的平台上运营业务。
覆盖 20,000+ GPU 的透明算力供给,按需租用、实时查询、快速交付。
FP32 51.2 TFLOPS / Tensor 756.0 TFLOPS
FP32 N/A / Tensor N/A
FP32 126.0 TFLOPS / Tensor 503.8 TFLOPS
FP32 19.5 TFLOPS / Tensor 312 TFLOPS
FP32 104.8 TFLOPS / Tensor 210 TFLOPS
FP32 15.7 TFLOPS / Tensor 125 TFLOPS
FP32 82.58 TFLOPS / Tensor 165.2 TFLOPS
FP32 35.58 TFLOPS / Tensor 71 TFLOPS
FP32 34.10 TFLOPS / Tensor 70 TFLOPS
FP32 19.17 TFLOPS / Tensor 76.7 TFLOPS
FP32 13.45 TFLOPS / Tensor 53.8 TFLOPS
INT8 N/A / INT16 N/A
根据机器在真实 AI 场景下的表现,帮助你判断租哪台更合适。
面向文本、图像、视频、语音等热门需求分配服务器资源。
实时查看机器的 Token 处理能力与任务表现,选择更有依据。
从租赁费用到运行产出,关键数据持续可见。
减少机器空闲与切换损耗,让服务器更专注于实际任务。
你关注机型和收益,平台处理接入与运行流程。
体验新一代 AI 基础设施。高性能 GPU 集群专为高要求工作负载而设计。
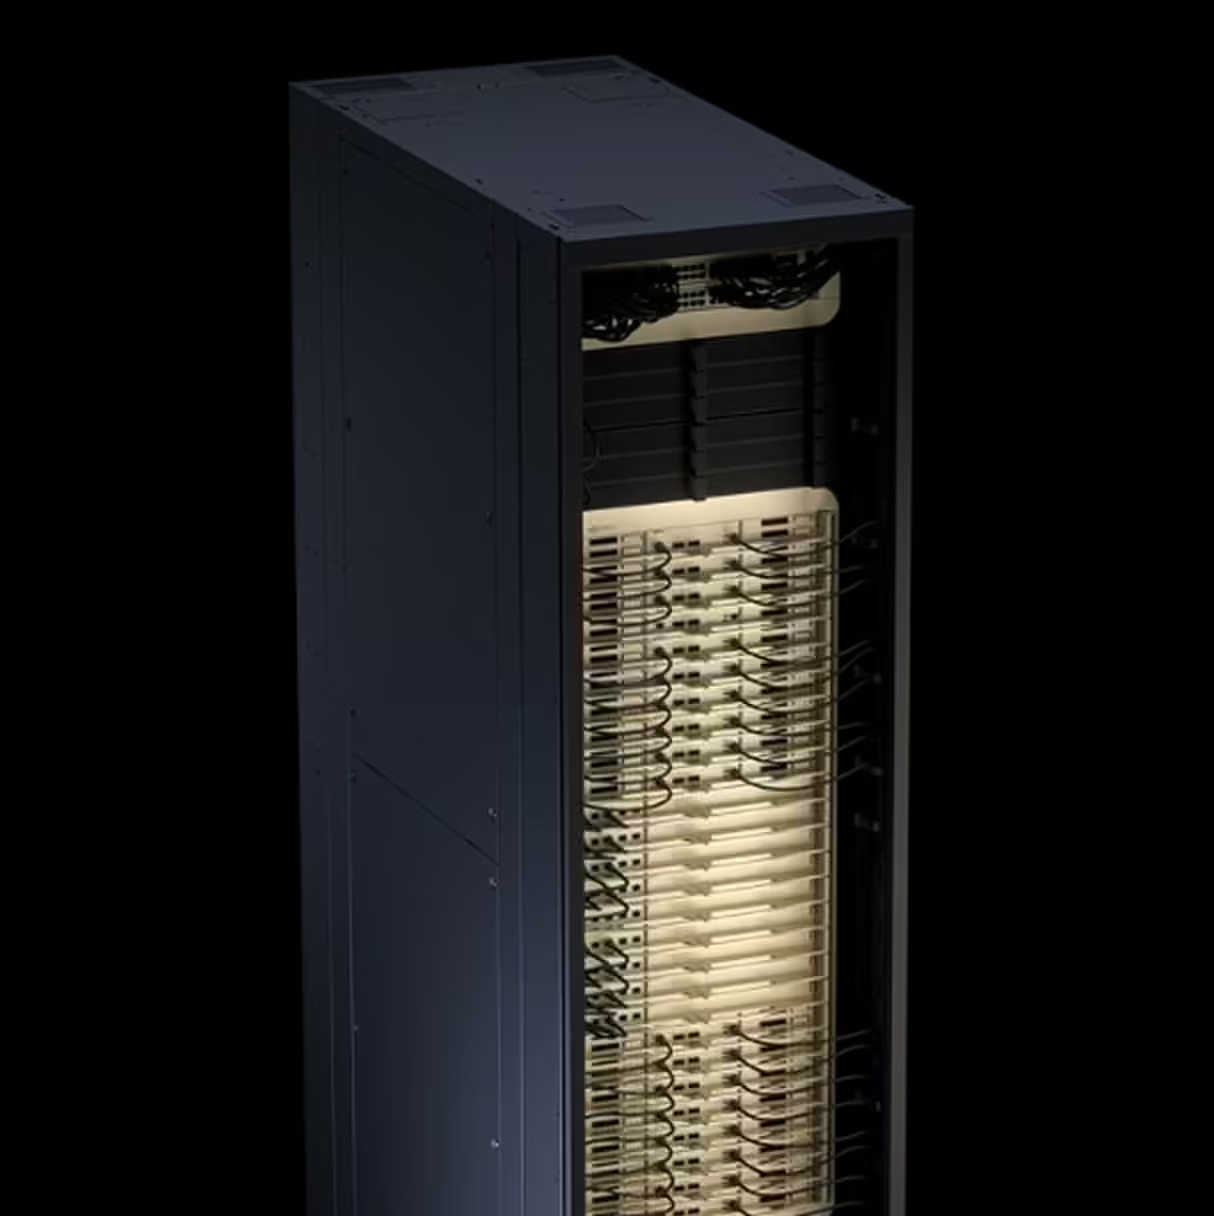
面向智能体 AI 优化的机架级系统。
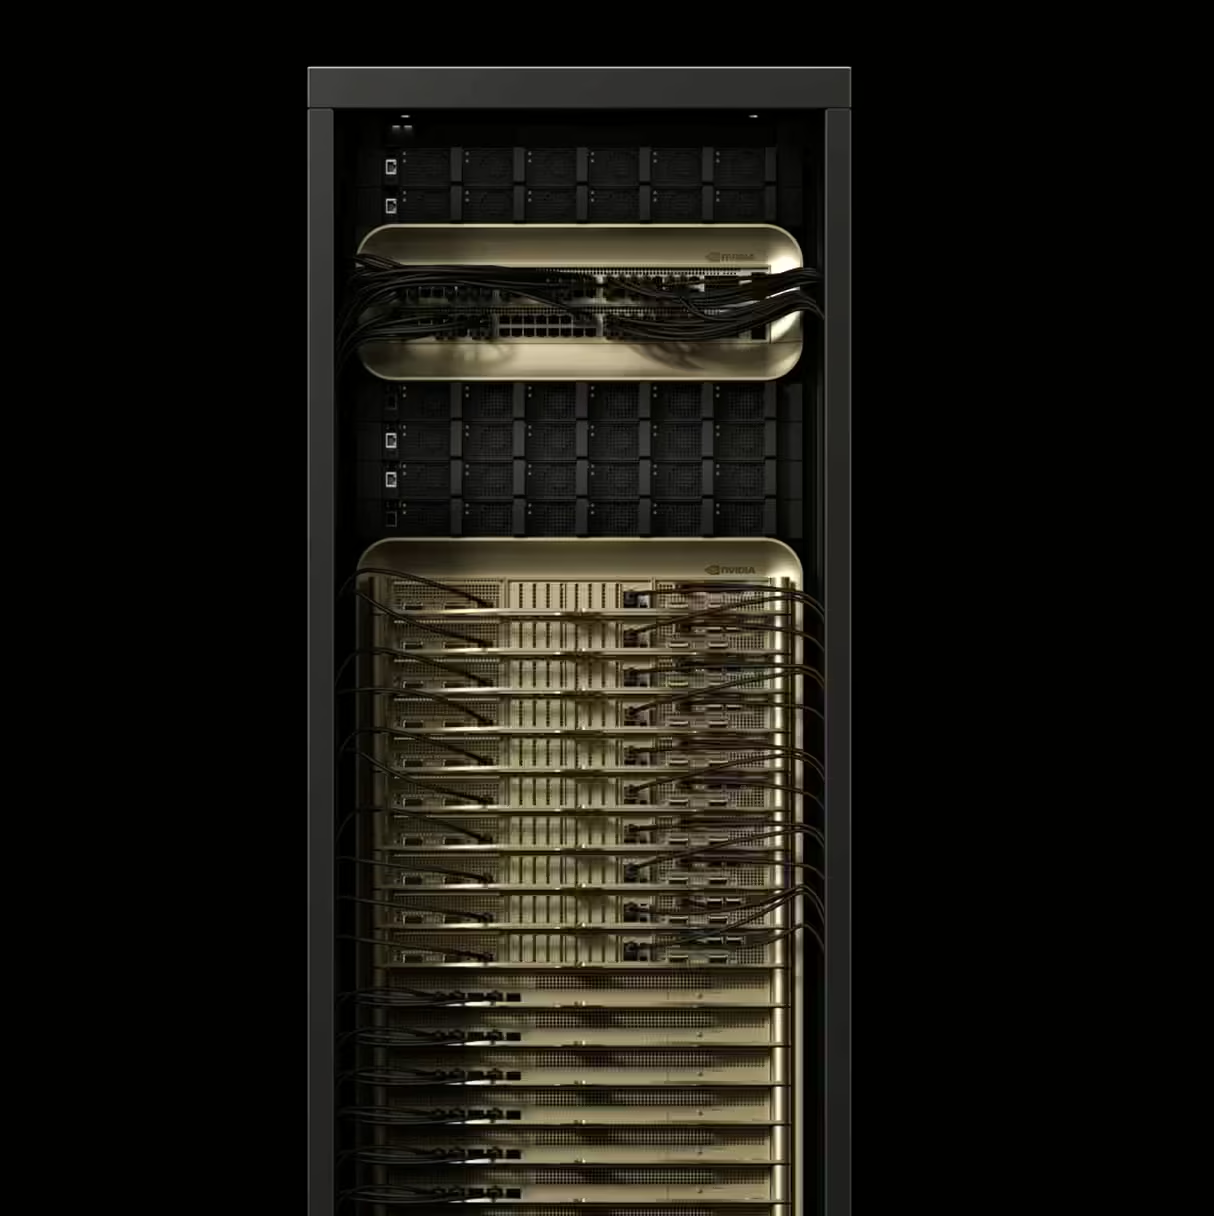
面向 AI 推理优化的机架级系统。
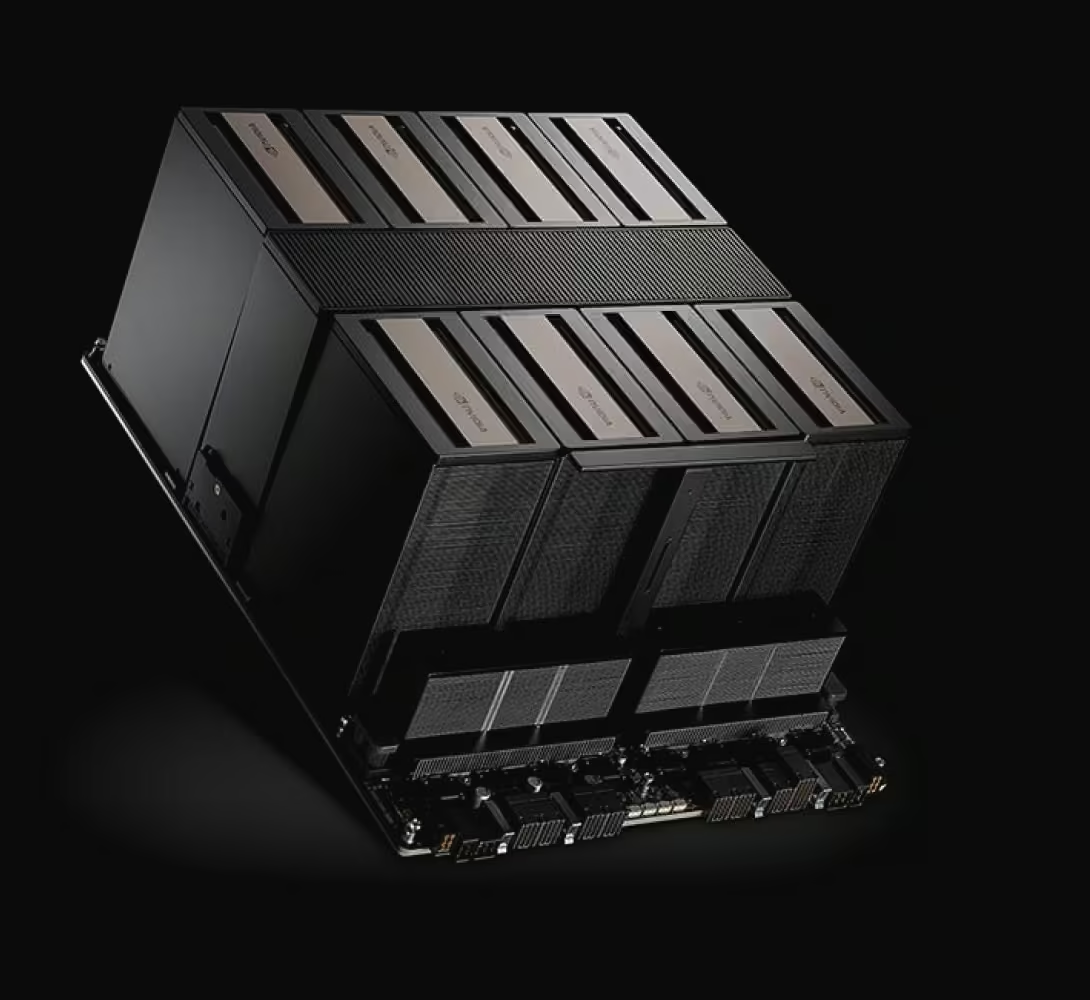
以峰值能效支持更长训练运行时间。
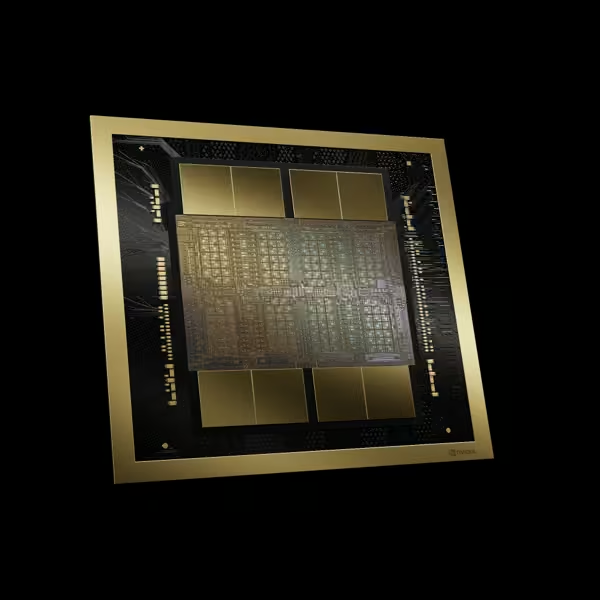
适合微调和推理的通用 GPU 基础设施。
我们通过提供高价值的性能、规模和专业知识,弥合人工智能雄心与执行之间的鸿沟。
10X
更快的推理启动时间
96%
集群吞吐量
50%
每天的中断减少
专为规模化而打造,安全可靠,旨在满足您最苛刻的需求。
凭借业界领先的可靠性,您可以自信地运行关键工作负载。
经独立审计的控制措施与端到端数据保护,支持企业安全要求。
利用可随您发展而扩展的基础设施,即时适应需求。
面向机器学习团队的探索、实验、协作和构建中心,把模型评估、数据集查看和项目展示放在同一个工作流里。
内置模型评估、数据集查看等机器学习工作流能力。

基于 Git,并以共享开发和评审为核心设计。
通过动手实验和优秀社区案例持续学习。
与世界分享你的作品,打造可展示的机器学习档案。
获取WebCal、GPU 集群和 AI 基础设施的最新实践与产品洞察。
前 OpenAI 研究员 Diogo Almeida 创办 TypeSafe AI,并推出不生成句子的决策模型 Jev。它以强类型选择、评分和概率输出,瞄准低延迟自动化、浏览器代理、上下文压缩和模型路由。
继续阅读Stripe被曝正以接近100亿美元估值洽谈收购OpenRouter。本文梳理OpenRouter的AI模型路由模式、增长与融资,以及Stripe从支付基础设施延伸至AI基础设施的战略逻辑,并对比国内外AI网关生态。
继续阅读从信息质量、上下文管理、提示词结构和模型选择出发,说明为什么 Token 越多不等于效果越好,并总结普通用户高效使用 AI 的五条原则。
继续阅读从输入和输出 Token、计费公式、长对话和文件成本讲起,解释模型价差、官方价格查询方式,以及普通用户如何减少无效 Token 消耗。
继续阅读